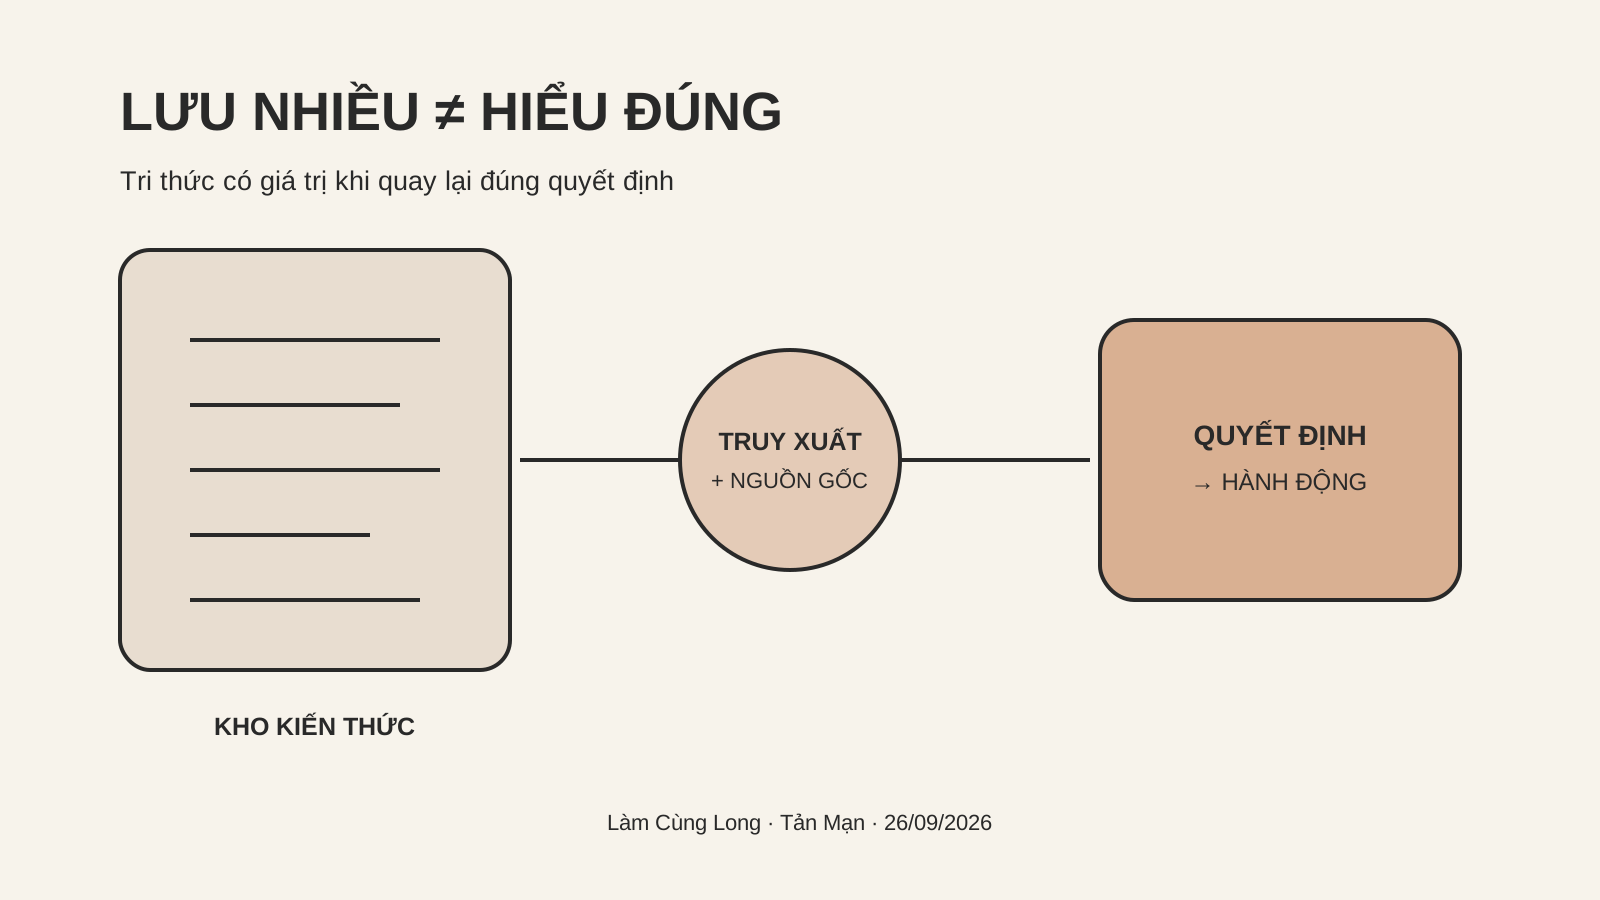
Có một kho kiến thức lớn chưa có nghĩa là có một hệ thống tri thức tốt
Vấn đề khó không còn là lưu thêm bao nhiêu, mà là khi cần quyết định, hệ thống có đưa đúng bằng chứng trở lại đúng ngữ cảnh hay không.
Có một giai đoạn rất dễ xảy ra khi bắt đầu nghiêm túc với việc học và quản trị tri thức: càng học nhiều, hệ thống càng lớn, nhưng cảm giác “mình đang thật sự hiểu và dùng được bao nhiêu?” lại không tăng tương ứng.
Tài liệu được lưu. Highlight được đồng bộ. Ghi chú được phân loại. Chat với AI được giữ lại. Có thêm Drive, Notion, Obsidian, database, bookmark, thư mục sách, bảng ý tưởng, danh sách bài cần đọc. Nếu dùng AI, ta còn có thể tự động hóa cả việc tóm tắt, gắn nhãn và liên kết.
Nhìn từ bên ngoài, đó giống một hệ thống tri thức ngày càng hoàn chỉnh.
Nhưng có một câu hỏi khó hơn: khi một quyết định thật xuất hiện, hệ thống ấy có giúp mình lấy đúng thứ cần thiết trở lại hay không?
Tôi ngày càng thấy đây mới là ranh giới giữa một kho kiến thức và một hệ thống tri thức.
Kho kiến thức trả lời câu hỏi: “Mình đã lưu những gì?”
Hệ thống tri thức phải trả lời thêm: “Thứ nào đáng tin, thứ nào liên quan đến vấn đề hiện tại, nó đến từ đâu, mình đã hiểu nó tới mức nào, và nó thay đổi hành động nào?”
1. Lưu được nhiều chỉ giải quyết bài toán không quên
Lưu trữ có giá trị. Không có lớp lưu trữ, nhiều ý tưởng tốt sẽ biến mất cùng một tab trình duyệt, một cuộc trò chuyện hoặc một ngày làm việc bận rộn.
Nhưng lưu trữ chủ yếu giải quyết một vấn đề: không để thông tin thất lạc.
Nó chưa tự giải quyết được bốn vấn đề khác:
- tìm lại đúng lúc;
- phân biệt nguồn mạnh và nguồn yếu;
- hiểu mối quan hệ giữa các mẩu thông tin;
- biến hiểu biết thành quyết định hoặc hành động.
Đây cũng là điểm tôi thấy thú vị trong cách Tiago Forte mô tả PARA và Building a Second Brain. Trọng tâm không chỉ là phân loại tài liệu đẹp hơn. PARA tổ chức thông tin theo mức độ có thể hành động, còn quá trình rộng hơn đi từ thu thập tới tổ chức, cô đọng rồi biểu đạt thành đầu ra.
Điều đáng chú ý không phải tên của bốn thư mục. Điều đáng chú ý là hướng chuyển động của thông tin.
Thông tin đi vào không phải để nằm yên.
Nó phải có đường quay trở lại công việc.
Nếu một ghi chú được lưu rất kỹ nhưng mỗi lần cần vẫn phải tìm lại từ đầu trên Google, đọc lại cả tài liệu hoặc hỏi AI như chưa từng học, phần lớn giá trị của việc lưu trữ chưa được chuyển hóa.
2. AI làm cho vấn đề “lưu quá nhiều” dễ xảy ra hơn
Trước đây, chi phí ghi chú còn tạo ra một bộ lọc tự nhiên. Muốn lưu một điều gì, ta thường phải đọc, chọn, copy, viết lại hoặc ít nhất bấm vài bước.
AI làm chi phí đó giảm mạnh.
Một video dài có thể thành bản tóm tắt. Một cuộc họp có thể thành biên bản. Một bài nghiên cứu có thể thành danh sách insight. Hàng trăm tài liệu có thể được phân loại tự động. Chat kéo dài nhiều tháng có thể được đưa vào memory hoặc retrieval system.
Đây là tiến bộ thật. Nhưng nó cũng tạo ra một nghịch lý: khả năng thu thập tăng nhanh hơn khả năng tiêu hóa.
Nếu mọi thứ đều đáng lưu vì việc lưu gần như miễn phí, kho tri thức có thể tăng rất nhanh nhưng tín hiệu hữu ích lại bị chìm trong chính lượng thông tin đó.
Các nghiên cứu về memory cho AI agent năm 2026 cũng đang chạm vào một bài toán tương tự ở cấp kỹ thuật. Microsoft Research mô tả trong PlugMem rằng lấy lại quá nhiều lịch sử thô có thể tạo ra lượng ngữ cảnh dài nhưng ít giá trị cho nhiệm vụ; hướng tiếp cận của họ là chuyển tương tác thành các đơn vị tri thức có thể tái sử dụng và truy xuất theo nhiệm vụ. Memora lại tập trung vào căng thẳng giữa tính cụ thể và tính khái quát: nén quá mạnh thì mất chi tiết, giữ mọi chi tiết thì việc truy xuất trở nên khó và tốn kém.
Tôi không xem các nghiên cứu này là công thức trực tiếp cho quản trị tri thức cá nhân. Nhưng chúng củng cố một trực giác quan trọng: có dữ liệu không đồng nghĩa với có đúng ngữ cảnh để suy nghĩ.
Và với con người, điều đó có lẽ còn đúng hơn.
3. Truy xuất đúng quan trọng hơn truy xuất nhiều
Khi xây một hệ thống tri thức, rất dễ bị hấp dẫn bởi câu hỏi “làm sao để AI đọc được tất cả dữ liệu của mình?”.
Tôi nghĩ câu hỏi tốt hơn là:
Trong tình huống này, AI hoặc chính mình nên đọc phần nào trước?
Một câu hỏi về một quyết định đang làm không nhất thiết cần toàn bộ lịch sử. Nó có thể chỉ cần:
- bối cảnh và ràng buộc hiện tại;
- bài học gần nhất có liên quan;
- khái niệm nền đã được kiểm chứng;
- bằng chứng gốc cho claim quan trọng;
- thông tin mới nếu vấn đề có tính thời sự.
Thứ tự này quan trọng.
Nếu một bản nháp AI cũ được lấy lên trước tài liệu gốc, ta có thể vô tình dùng kết luận đã qua nhiều lớp biến đổi như bằng chứng. Nếu một insight mới chưa được kiểm chứng được đặt ngang với một nguồn chính thức, hệ thống có thể tạo cảm giác chắc chắn giả. Nếu mọi ghi chú cùng mức ưu tiên, “search được” vẫn chưa có nghĩa là “retrieval tốt”.
Vì vậy tôi ngày càng thích tư duy routing hơn tư duy “một kho chứa tất cả”.
Mỗi loại câu hỏi nên có đường tìm nguồn phù hợp.
Thông tin hiện hành đi về nguồn chính thức mới nhất. Bài học cá nhân đi về nhật ký hoặc lesson đã ghi nhận. Một khái niệm đi về bản canonical đã cô đọng. Một claim quan trọng phải có đường quay lại evidence và nguồn gốc. Sách là nền tư duy, nhưng không nên được dùng để xác nhận một tính năng phần mềm đã thay đổi.
Hệ thống tốt không cần đưa mọi thứ lên bàn.
Nó cần biết thứ gì chưa nên đưa lên bàn.
4. Nguồn gốc quan trọng không kém nội dung
Một câu rất hợp lý có thể đến từ một nguồn rất yếu.
Đây là điều AI làm cho khó nhận ra hơn, vì khi mọi thứ được viết lại bằng cùng một giọng văn trôi chảy, ranh giới giữa fact, diễn giải, giả thuyết và ý tưởng dễ bị xóa mờ.
Ví dụ, bốn câu sau có thể nhìn giống nhau trong một note:
- tài liệu chính thức xác nhận một tính năng;
- một bài báo diễn giải tính năng đó;
- một người dùng kể trải nghiệm;
- AI suy luận khả năng ứng dụng.
Nhưng chúng không có cùng trọng lượng.
Nếu hệ thống chỉ lưu phần “nội dung cuối cùng”, ta mất đi một phần quan trọng của tri thức: lineage — nó đến từ đâu và đã qua những bước biến đổi nào.
Vì vậy, với những điều có thể ảnh hưởng đến quyết định, tôi thấy một chuỗi đơn giản rất đáng giữ:
Claim → Evidence → Source → thời điểm kiểm chứng.
Không phải mọi ghi chú đều cần quy trình nặng như vậy. Một ý tưởng cá nhân có thể chỉ cần ghi rõ đó là góc nhìn. Nhưng khi một câu được dùng như fact, nguồn gốc trở thành một phần của chính câu đó.
Điều này cũng giúp AI hữu ích hơn. Thay vì yêu cầu AI “tin” vào toàn bộ kho kiến thức, ta cho nó biết lớp nào là nguồn sự thật, lớp nào là insight, lớp nào chỉ là content idea và lớp nào cần kiểm tra lại.
Đó không chỉ là quản trị file.
Đó là quản trị độ chắc chắn.
5. Cô đọng không phải là tóm tắt cho ngắn
Một hệ thống lớn sớm muộn cũng cần nén.
Nhưng nén tốt không đơn giản là biến 20 trang thành 2 trang, rồi 2 trang thành 10 bullet.
Nếu nén sai, ta có thể giữ câu kết luận nhưng mất điều kiện khiến kết luận đó đúng.
Tôi thích nhìn việc cô đọng theo một mục tiêu khác: giảm chi phí để lần sau hiểu lại, nhưng vẫn giữ đường quay về chi tiết khi cần.
Một ghi chú bài học tốt chẳng hạn không cần chứa toàn bộ câu chuyện. Nó cần giữ được bài học cốt lõi, bối cảnh đủ để không hiểu sai và dấu vết dẫn về bằng chứng nếu sau này muốn đào sâu.
Một canonical note cũng vậy. Nó không phải bản sao ngắn hơn của tất cả nguồn. Nó là một điểm truy cập tốt hơn vào những gì đã được hiểu.
Ở đây, Progressive Summarization của Building a Second Brain có một ý rất thực dụng: các lớp cô đọng giúp ta quay lại một ghi chú ở nhiều độ sâu khác nhau mà không xóa bản gốc. Cách làm cụ thể có thể thay đổi, nhưng nguyên tắc đáng giữ là nén phải thuận nghịch về mặt truy xuất.
Khi cần nhanh, đọc essence.
Khi cần chắc, quay lại evidence.
6. Tri thức chỉ hoàn tất một vòng khi nó quay lại hành động
Tôi nghĩ đây là phần dễ bị bỏ quên nhất.
Ta thường đo hệ thống bằng số note, số nguồn, số kết nối, số automation hoặc cảm giác “mọi thứ đã được tổ chức”.
Nhưng nếu mục tiêu cuối cùng là làm việc và ra quyết định tốt hơn, các chỉ số đó mới chỉ mô tả hạ tầng.
Một vòng tri thức đầy đủ hơn có thể là:
Thu thập → Kiểm chứng → Cô đọng → Truy xuất → Quyết định → Hành động → Phản hồi → Cập nhật tri thức.
Điểm cuối rất quan trọng.
Khi đó, hệ thống tri thức không còn là thư viện.
Nó trở thành một vòng học.
Và đây có lẽ là khác biệt lớn nhất giữa việc “có rất nhiều thứ để AI đọc” và việc “có một hệ thống giúp AI lẫn con người suy nghĩ tốt hơn”.
7. Một bài kiểm tra đơn giản cho hệ thống tri thức
Thay vì hỏi “hệ thống của mình đã đủ lớn chưa?”, có thể thử bằng một quyết định thật.
Chọn một vấn đề đang làm và hỏi:
Tôi có tìm được đúng bối cảnh không? Hay phải kể lại từ đầu?
Tôi có biết đâu là nguồn đáng tin nhất không? Hay mọi file đều ngang hàng?
Một claim quan trọng có truy ngược được không? Hay chỉ còn bản tóm tắt?
Tôi có phân biệt được fact, giả thuyết và góc nhìn không?
Hệ thống có giúp tôi đi tới một hành động cụ thể không?
Sau hành động, kết quả có quay lại làm hệ thống tốt hơn không?
Nếu phần lớn câu trả lời là “chưa”, vấn đề có thể không nằm ở việc thiếu thêm một công cụ quản trị tri thức.
Có thể ta chỉ đang thiếu những đường nối giữa lưu trữ, hiểu, quyết định và hành động.
Kết
Tôi vẫn thấy việc lưu trữ, tổ chức và xây một “bộ não thứ hai” rất đáng làm. Trong thời đại AI, giá trị của một kho dữ liệu cá nhân có thể còn tăng lên vì máy có khả năng đọc, liên kết và truy xuất nhanh hơn con người rất nhiều.
Nhưng chính vì khả năng thu thập đã trở nên quá dễ, tiêu chuẩn cho một hệ thống tốt cũng nên cao hơn.
Không phải lưu được bao nhiêu.
Không phải AI đọc được bao nhiêu.
Không phải có bao nhiêu database, graph hay automation.
Mà là: khi đứng trước một vấn đề thật, hệ thống có đưa đúng tri thức, đúng nguồn gốc và đúng mức độ chắc chắn trở lại để giúp mình hành động tốt hơn hay không.
Nếu có, kho kiến thức bắt đầu trở thành một hệ thống.
Nếu chưa, có lẽ việc cần làm tiếp theo không phải là lưu thêm.