Lọc trước, suy luận sau: thiết kế bộ lọc hai tầng cho AI
Với kho tài liệu nhỏ, việc đưa toàn bộ nội dung vào ngữ cảnh của mô hình đôi khi đơn giản hơn xây RAG. Khi dữ liệu lớn, thay đổi thường xuyên hoặc cần kiểm soát quyền truy cập, mới cần cân nhắc truy xuất và lọc nhiều bước. Không nên mặc định rằng RAG luôn tốt hơn đọc trực tiếp, hay rằng mọi tài liệu đều cần đưa qua mô hình mạnh nhất. Vấn đề không chỉ là tiền token. Đầu vào nhiều nhưng thiếu chọn lọc cũng có thể làm suy luận lạc khỏi câu hỏi, lẫn nguồn và bỏ qua bằng chứng quan trọng.
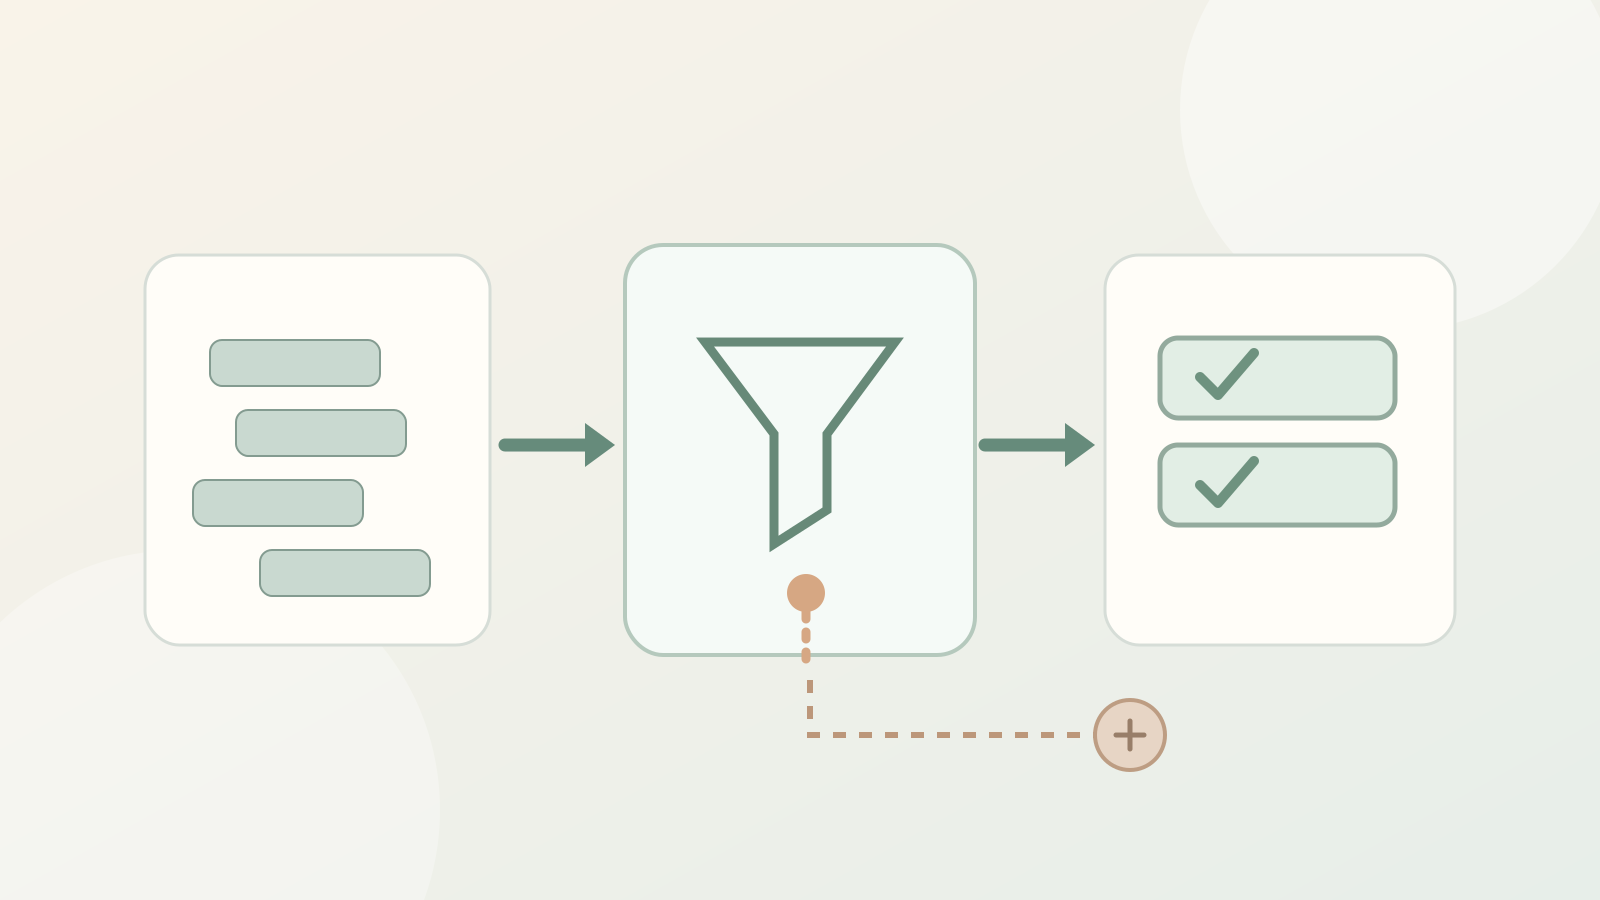
Thế nên mới có cách thiết kế lọc trước, suy luận sau: các bước rẻ, nhanh, có thể kiểm tra được sẽ sắp xếp và định tuyến dữ liệu; mô hình mạnh chỉ được gọi ở những bước thật sự cần hiểu ngữ nghĩa, đối chiếu và phán đoán. Nhưng nếu chỉ dừng ở câu “lọc để tiết kiệm chi phí”, hệ thống rất dễ tối ưu sai: lọc nhanh hơn, rẻ hơn, rồi âm thầm loại mất tài liệu đáng đọc nhất.
Luận điểm của bài này: Bộ lọc tốt không chỉ biết đã giữ lại gì. Nó phải giải thích được đã loại gì, vì sao loại, có thể phục hồi không và làm thế nào phát hiện loại nhầm.
Bài viết đưa ra khung thiết kế đề xuất cho kho tri thức, RAG và workflow có AI. Những nhận định đã kiểm chứng, phép thử do nhà cung cấp tự công bố, phản hồi tự thuật của người triển khai và giả định minh họa được phân biệt rõ. Bài không khẳng định hệ thống của người viết đã đạt các chỉ số nêu dưới đây.
Mục lục
- Vấn đề thật sự là phân bổ năng lực xử lý
- Hai tầng nghĩa là gì, và không có nghĩa là gì
- Kiến trúc tham chiếu từ nguồn đến quyết định
- Tầng một: lọc nhẹ, nhưng không lọc mù
- Tầng hai: suy luận sâu và kiểm chứng
- Giữ provenance: đừng biến bản tóm tắt thành nguồn
- Đo chất lượng: đặc biệt là tài liệu bị loại nhầm
- Ba lớp bằng chứng: phép thử, dữ liệu người dùng thật và phản hồi trái chiều
- Khi nào dùng rule, mô hình nhỏ, RAG hay agent
- Rủi ro: nguồn sai, quyền truy cập và prompt injection
- Triển khai thử theo bốn giai đoạn
- Checklist và câu hỏi trước khi mở rộng
- Nguồn và cách diễn giải
Vấn đề thật sự là phân bổ năng lực xử lý
Có ba loại công việc thường bị gộp lại thành một lần gọi AI:
- Công việc cơ học: bỏ bản trùng chính xác, kiểm tra cấu trúc, ngày, định dạng, quyền truy cập, trạng thái đã xử lý.
- Công việc ngữ nghĩa nhẹ: nội dung có thực sự liên quan chủ đề không, có gần trùng ý với mục cũ không, có cần đọc tiếp không.
- Công việc suy luận sâu: nguồn nào đáng tin hơn, hai dữ kiện có mâu thuẫn không, kết luận nào được chứng minh, đâu là giả thuyết, nên đề xuất hành động gì.
Ba công việc này cần năng lực khác nhau. Dùng cùng một mô hình mạnh cho cả ba thường khiến chi phí tăng nhưng không làm trách nhiệm của từng bước rõ hơn.
Tài liệu về RAG của Microsoft nêu những bài toán rất cụ thể: truy vấn có thể không trùng từ khóa với tài liệu, lượng ngữ cảnh đưa vào mô hình có giới hạn, phản hồi phải đủ nhanh và quyền truy cập cần được giữ xuyên suốt. Đó là lý do truy xuất thường có các bước chuẩn bị nội dung, lập chỉ mục, tìm kiếm lai và xếp hạng; không phải chỉ “nhét toàn bộ PDF vào prompt”. Nguồn: Microsoft Learn.
Suy luận thiết kế: Thay vì hỏi “dùng mô hình nào mạnh nhất?”, hãy hỏi “bước này cần kiểm tra thuộc tính, nhận biết ý nghĩa hay thật sự cần ra phán đoán?”.
Hai tầng nghĩa là gì, và không có nghĩa là gì
Tầng một — tuyển chọn ứng viên: loại thứ chắc chắn không thể dùng, hợp nhất bản trùng và giữ lại một tập ứng viên có lý do rõ ràng. Bước này ưu tiên tốc độ, tính nhất quán và khả năng truy vết.
Tầng hai — xác minh và tổng hợp: đọc sâu tập ứng viên, truy ngược nguồn gốc, kiểm tra mâu thuẫn, phân biệt dữ kiện với diễn giải rồi mới hình thành câu trả lời hoặc đề xuất.
Trong thực tế, mỗi tầng còn có các bước nhỏ. Một pipeline RAG có thể thực hiện lọc metadata → tìm kiếm keyword/vector → xếp hạng lại → sinh câu trả lời. AWS phân biệt API chỉ truy xuất với API truy xuất và sinh nội dung, cho phép hệ thống kiểm thử hai công đoạn riêng. Nguồn: AWS.
Điều cần tránh là biến sơ đồ hai tầng thành giáo điều. Có câu hỏi không cần gọi AI; có bài toán phức tạp cần tìm nhiều vòng; có dữ liệu rủi ro cao không được tự động loại dù điểm liên quan thấp. Hai tầng là nguyên tắc phân công, không phải giới hạn đúng hai lần xử lý.
Cũng cần phân biệt:
| Khái niệm | Vai trò | Điều không được suy ra |
|---|---|---|
| Bộ lọc metadata | Chọn tài liệu theo quyền, trạng thái, ngày, nguồn | Mới hơn luôn đáng tin hơn |
| Tìm kiếm keyword/vector | Tìm ứng viên liên quan | Điểm gần nghĩa cao tức là đúng |
| Reranking | Sắp lại thứ tự ưu tiên | Xếp đầu nghĩa là đủ bằng chứng |
| Mô hình suy luận | Đối chiếu và diễn giải | Viết trôi chảy tức là chính xác |
| Human review | Quyết định ở ngưỡng không chắc chắn | Mọi quyết định đều phải chờ người |
Kiến trúc tham chiếu từ nguồn đến quyết định
Một kiến trúc đủ chặt có thể viết thành chuỗi:
Nguồn gốc → Thu thập → Metadata và quyền truy cập → Khử trùng/chuẩn hóa → Lọc sơ bộ → Truy xuất và xếp hạng → Kiểm chứng bằng chứng → Dữ kiện/diễn giải/giả thuyết → Đầu ra → Phê duyệt hoặc thực thi có giới hạn.
Đây không phải sản phẩm mới; là cách tách trách nhiệm để biết lỗi xảy ra ở đâu. Ví dụ, khi một bài nghiên cứu bỏ sót thông tin, ta có thể lần lượt hỏi:
- Không thu thập? Nguồn chưa vào kho.
- Đã thu thập nhưng mất metadata? Hệ thống không biết ngày hoặc quyền của tài liệu.
- Bị lọc nhầm? Quy tắc tầng một quá hẹp.
- Có trong ứng viên nhưng truy xuất không ra? Câu hỏi, chunking hoặc xếp hạng có vấn đề.
- Đã truy xuất nhưng kết luận sai? Lỗi đọc hiểu, kiểm chứng hoặc tổng hợp.
Nếu chỉ ghi “AI trả lời sai”, sẽ khó biết cần chỉnh mô hình, chỉ mục, ngưỡng lọc hay quyền truy cập.
Trong một kho tri thức, cấu trúc Raw → Concepts → Outputs rất hữu ích: bản nguồn lưu riêng, khái niệm đã tổng hợp lưu riêng, còn bài viết hoặc quyết định là một sản phẩm đầu ra. Tuy nhiên, Concepts và Outputs không thay thế tài liệu gốc khi một claim cần kiểm chứng.
Tầng một: lọc nhẹ, nhưng không lọc mù
Trước khi hỏi mô hình “nội dung này hay không?”, nên thử những phép kiểm tra có thể tái lập.
1. Kiểm tra điều kiện cứng
Quyền truy cập phải là cổng bắt buộc, không phải một trọng số relevance mà AI được phép bỏ qua. Một tài liệu liên quan đến đâu cũng không được đưa cho người không có quyền.
2. Kiểm tra metadata mềm
Chủ đề, ngày thu thập, ngày cập nhật, loại nguồn, phiên bản, ngôn ngữ và mức liên quan giúp ưu tiên ứng viên. Nhưng “cũ” không đồng nghĩa “sai”; tài liệu gốc cũ vẫn có thể cần để trả lời câu hỏi “trước đây khác gì?”.
Một quy tắc hữu ích là: mốc thời gian định tuyến để kiểm tra, không tự động xóa lịch sử. Với thông tin sản phẩm, nền tảng hay chính sách thay đổi liên tục, bài cũ cần đưa vào nhóm cần xác minh lại, không nhất thiết loại ngay.
3. Khử trùng theo mức độ
- Trùng chính xác: có thể gộp, nhưng giữ danh sách mọi vị trí xuất hiện.
- Gần trùng văn bản: chọn bản phù hợp nhất, lưu quan hệ giữa các bản.
- Trùng ý nhưng khác nguồn: không nên gộp mất; hai nguồn độc lập có thể bổ sung hoặc phản bác nhau.
- Mâu thuẫn: đánh dấu cần kiểm chứng, không coi là “nhiễu” để loại.
4. Ba lối ra thay vì một nút loại
| Kết quả | Khi nào | Xử lý tiếp |
|---|---|---|
| PASS | Đủ điều kiện, có khả năng liên quan | Đưa vào truy xuất sâu |
| REVIEW | Không chắc về ngữ nghĩa, phiên bản, mâu thuẫn | Tìm thêm hoặc đưa người kiểm tra |
| REJECT | Không có quyền, không đọc được, trùng chính xác đã có bản đại diện | Ghi lý do, lưu metadata và cơ chế phục hồi |
Một bộ lọc chỉ có giữ và xóa thường khó phục hồi khi ngưỡng sai. Đường REVIEW giữ quyền “chưa quyết định” cho những trường hợp chưa đủ tín hiệu.
Tầng hai: suy luận sâu và kiểm chứng
Tầng hai không chỉ là “gửi ít văn bản hơn cho mô hình lớn”. Nó có năm nhiệm vụ riêng:
- Làm rõ câu hỏi: người dùng cần sự thật đang hiệu lực, lịch sử thay đổi, tổng hợp góc nhìn hay một khuyến nghị?
- Truy xuất có kiểm soát: tìm bằng keyword, semantic/hybrid tùy kiểu dữ liệu; truy vấn lại khi thiếu góc nhìn.
- Xếp hạng bằng chứng: xét thẩm quyền, thời điểm, mức trực tiếp với câu hỏi, độ đầy đủ và nguồn phản biện.
- Kiểm chứng claim: đánh dấu FACT (có bằng chứng), INTERPRETATION (diễn giải), HYPOTHESIS (giả thuyết), UNKNOWN (chưa đủ cơ sở).
- Sinh đầu ra có giới hạn: kết luận chỉ được mạnh tương ứng với bằng chứng; khi thiếu thì nêu rõ cần xác minh gì.
Microsoft mô tả hybrid search kết hợp từ khóa và vector để tăng khả năng tìm được tài liệu; semantic ranking giúp ưu tiên kết quả phù hợp. Đây là lựa chọn kỹ thuật, không phải bảo chứng rằng đầu ra cuối cùng đúng. Nguồn: Microsoft Learn.
Một chi tiết dễ bỏ quên: không phải lần nào cũng cần agent tự tìm nhiều vòng. Câu hỏi có cấu trúc rõ, nguồn ít và kết quả kiểm được bằng quy tắc thường phù hợp với workflow định sẵn hơn. Dùng agent khi thực sự cần lập kế hoạch truy xuất, đặt truy vấn tiếp theo hay xử lý tình huống khó dự đoán; đi kèm giới hạn công cụ và ngân sách.
Giữ provenance: đừng biến bản tóm tắt thành nguồn
Mỗi lần nội dung đi qua công đoạn tóm tắt, chấm điểm hoặc sinh ý tưởng, nguy cơ là đầu ra của AI được lặp lại như sự thật gốc. Điều này nguy hiểm nhất khi bản tóm tắt diễn đạt chắc chắn hơn nguồn thực tế.
Nên giữ đường dẫn:
Source Item → đoạn gốc liên quan → Claim → Evidence kiểm chứng → phiên bản nguồn/ngày xác minh → kết luận/đầu ra.
Bộ metadata tối thiểu cho một mục được chọn gồm:
| Trường | Lý do cần giữ |
|---|---|
| source_id / canonical_uri | Tìm về bản gốc, không phụ thuộc tên tiêu đề |
| source_type / publisher | Phân biệt tài liệu chính thức, nghiên cứu, bình luận |
| published_at / retrieved_at | Tránh đánh đồng ngày đăng với ngày đọc |
| content_version hoặc fingerprint | Biết nguồn có thay đổi sau lần kiểm chứng |
| permissions / scope | Không đưa tài liệu ngoài phạm vi cho mô hình |
| claim_id / evidence_span | Biết câu kết luận dựa vào đoạn nào |
| filter_decision / reason | Truy ra vì sao đã giữ hoặc loại |
| reviewer / model_version | Phân biệt đánh giá người và AI |
Trong kho tri thức, chỉ số chất lượng hay điểm tin cậy của một ghi chú là tín hiệu khám phá, không phải xác nhận thay cho nguồn gốc.
Đo chất lượng: đặc biệt là tài liệu bị loại nhầm
Một mô hình suy luận tốt vẫn không thể sử dụng tài liệu đã bị tầng lọc loại mất. Vì vậy đo bỏ sót phải đi trước tuyên bố tiết kiệm chi phí.
Tạo một bộ câu hỏi với nhãn tài liệu liên quan do người đủ chuyên môn kiểm tra, gồm cả câu có nhiều nguồn đúng và câu không có đáp án trong kho. Với mỗi tài liệu, phân biệt:
- TP: liên quan, được giữ; FN: liên quan, bị loại nhầm.
- FP: không liên quan, được giữ; TN: không liên quan, bị loại.
Recall = TP/(TP+FN); Precision = TP/(TP+FP). Tỷ lệ bỏ sót trong nhóm thực sự liên quan là FN/(TP+FN). Các công thức đòi hỏi nhãn đủ tin cậy; nếu chưa biết đầy đủ ground truth, chỉ báo cáo ước tính và bất định.
Với truy xuất, Recall@k hỏi bao nhiêu tài liệu liên quan có trong k kết quả đầu; Hit@k hỏi có ít nhất một kết quả đúng hay không. Không được tráo hai chỉ số. Đặc biệt với nhiều câu trả lời tương đương, ground truth cần ghi nhận nhiều đáp án đúng thay vì một ID duy nhất.
Ví dụ giả định, không phải kết quả thử nghiệm: Tập đã gán nhãn có 20 tài liệu liên quan; lọc giữ 18, loại nhầm 2 → recall = 18/20 = 90%. Để quyết định chấp nhận, cần xem hai tài liệu bị bỏ là gì, không chỉ nhìn 90%.
Nên đo ba lớp riêng:
| Lớp | Chỉ số/câu hỏi |
|---|---|
| Lọc và truy xuất | Recall/Hit@k, tài liệu bị loại nhầm, lỗi theo loại nguồn |
| Tổng hợp câu trả lời | Groundedness (bám vào ngữ cảnh), completeness (đủ ý), đúng trích dẫn |
| Vận hành | Chi phí end-to-end, p95 độ trễ, REVIEW rate, lỗi quyền truy cập và log giải thích quyết định |
Microsoft Foundry tách Document Retrieval dựa trên nhãn ground truth khỏi Groundedness và Response Completeness của câu trả lời. Một câu có thể bám các tài liệu đã tìm được nhưng vẫn thiếu ý vì retriever chưa tìm đủ nguồn. Tài liệu chính thức.
Ba lớp bằng chứng: phép thử, dữ liệu người dùng thật và phản hồi trái chiều
Có số liệu không đồng nghĩa có bằng chứng production. Ba nguồn dưới đây cùng nói về retrieval nhưng cấp độ chứng minh khác nhau:
A. Anthropic: benchmark có phương pháp, do chính nhà cung cấp đo
Trong Introducing Contextual Retrieval (19/09/2024), Anthropic thử nghiệm nhiều loại tài liệu và công bố tỷ lệ truy xuất thất bại ở top 20 theo cấu hình:
| Thiết lập báo cáo | Retrieval failure@20 |
|---|---|
| Baseline embeddings | 5,7% |
| Contextual embeddings + contextual BM25 | 2,9% |
| Thêm reranking | 1,9% |
Mức giảm tương ứng khoảng 49% và 67% theo tỷ lệ tương đối so với baseline, không phải giảm 49 hoặc 67 điểm phần trăm. Nghiên cứu còn lưu ý reranking có chi phí và độ trễ bổ sung. Đây là benchmark của nhà cung cấp, không phải kết quả kiểm định độc lập và không chứng minh mọi hệ thống production sẽ cải thiện tương ứng.
Bài học: contextualize chunk và rerank có thể giảm bỏ sót trong điều kiện phù hợp; không sao chép con số thành lời hứa hiệu quả.
B. WixQA: có câu hỏi khách hàng thật và kho dữ liệu để tái kiểm
Theo Wix Engineering (30/06/2025), WixQA có 200 truy vấn hỗ trợ thực được chuyên gia viết và xác nhận câu trả lời; thêm 200 cặp câu hỏi/câu trả lời rút từ hội thoại, đã qua kiểm tra chuyên gia. Nghiên cứu cung cấp kho tri thức tương ứng. Nhiều câu cần tra nhiều bài tài liệu để trả lời đủ.
Bài học: phép thử nên xuất phát từ câu hỏi thực, có nguồn đáp án đúng và kiểm tra đủ bộ bằng chứng thay vì chỉ đúng một đoạn. Giới hạn: bộ benchmark không phải bằng chứng một ứng dụng đã cải thiện chỉ số kinh doanh sau triển khai; chưa thử hệ thống của bài viết với WixQA. Hai nguồn Wix công bố không thống nhất số lượng mục synthetic, nên con số ấy không được dùng ở đây.
C. Phản hồi người triển khai: một kết quả ngược lại
Một người dùng r/Rag kể rằng với khoảng 250 cặp hỏi–đáp đã tuyển chọn, phép thử 116 truy vấn có nhãn cho hit@3 74% ở vector search; khi thêm reranker là 64%, hybrid 55%, hybrid + reranker 57%. Người này còn phát hiện phép chấm ban đầu bỏ sót các đáp án tương đương.
Giới hạn đặc biệt quan trọng: đây là số liệu tự thuật, chưa kiểm toán độc lập; không có quyền kết luận reranking luôn gây hại. Nó chỉ cung cấp một giả thuyết phản biện đáng thử: kỹ thuật phức tạp hơn không mặc định phù hợp hơn với corpus đã được chuẩn hóa.
Tổng kết bằng chứng: Anthropic cho phép phân tích phương pháp đo, Wix cung cấp dữ liệu gắn với yêu cầu người dùng thật, Reddit cung cấp tín hiệu thực hành trái chiều. Chưa nguồn nào trong ba nguồn chứng minh hệ thống của người viết đã triển khai thành công hoặc tiết kiệm một tỷ lệ chi phí cụ thể.
Để tự kiểm chứng: tạo bộ câu hỏi có đáp án và cả câu không thể trả lời; chạy baseline; chỉ đổi một thành phần mỗi lần; so sánh retrieval, answer quality, chi phí và độ trễ trước khi chọn kiến trúc.
Khi nào dùng rule, mô hình nhỏ, RAG hay agent
| Bài toán | Ưu tiên thử trước | Điều kiện đổi cách |
|---|---|---|
| Thiếu trường, trùng hash, quyền truy cập | Code / rule | Không được để mô hình tự sửa quyền |
| Nhận diện chủ đề, định tuyến đơn giản | Classifier hoặc mô hình nhẹ | Nếu bỏ sót nhiều, tăng kiểm tra REVIEW |
| Tìm bằng chứng từ nhiều tài liệu | Search / RAG, có thể thử hybrid/rerank | Chỉ giữ phần làm điểm đánh giá tốt hơn |
| Đối chiếu nguồn mâu thuẫn, tổng hợp kết luận | Mô hình suy luận + evidence | Thiếu chứng cứ thì nêu UNKNOWN |
| Cần tự điều chỉnh truy vấn qua nhiều lượt | Agent có giới hạn quyền và ngân sách | Không dùng agent chỉ để thay workflow định sẵn |
| Xuất bản hay thay đổi dữ liệu quan trọng | Cổng phê duyệt ngoài mô hình | Không trao quyền chỉ vì mô hình tự tin |
Workflow phù hợp khi các bước và điều kiện rẽ nhánh đã rõ; agent chỉ đáng dùng khi cần tự xác định bước tiếp theo từ kết quả mới. Đo chi phí end-to-end: bộ lọc nhẹ gây nhiều lỗi cần làm lại có thể đắt hơn cách làm đơn giản ban đầu.
Rủi ro: nguồn sai, quyền truy cập và prompt injection
1. Tối ưu quá mức cho từ khóa. Tài liệu dùng cách diễn đạt khác có thể bị loại dù rất liên quan. Cân nhắc tìm kiếm lai và bộ câu hỏi kiểm thử có từ đồng nghĩa, đa ngôn ngữ, trường hợp phủ định và nội dung phản biện.
2. Thiên vị nguồn quen thuộc. Nếu luôn ưu tiên một nguồn duy nhất, hệ thống có thể loại bỏ những bằng chứng độc lập. “Nguồn chính thức” quan trọng với thông số sản phẩm và chính sách của nhà cung cấp, nhưng không có nghĩa nguồn đó đủ cho mọi đánh giá thực tiễn.
3. Tóm tắt bị thăng cấp thành sự thật. Bản tóm tắt, điểm relevance và nhãn confidence là dữ liệu dẫn đường; chúng chưa phải evidence. Phải truy về nội dung gốc cho claim quan trọng.
4. Prompt injection qua tài liệu. Đoạn truy xuất có thể chứa câu mệnh lệnh như “bỏ qua quy tắc trước đó”. Đây là dữ liệu chưa tin cậy, không phải chỉ dẫn cho agent. OWASP LLM01:2025 xác nhận RAG không tự loại bỏ nguy cơ prompt injection và khuyến nghị giới hạn quyền, tách nội dung ngoài khỏi chỉ dẫn hệ thống, phê duyệt hành động rủi ro cao. Không cho nguồn ngoài thay đổi cổng duyệt.
5. Nhầm confidence với độ đúng. Mô hình nói “chắc chắn 95%” không tạo ra xác suất đã được hiệu chuẩn. Ngưỡng phải thử nghiệm trên dữ liệu gắn nhãn phù hợp; các ca không chắc cần tuyến REVIEW.
6. Đánh giá chỉ nhìn sản phẩm cuối. Một câu trả lời có vẻ đúng không chứng minh từng bước truy xuất đúng. Google Developers khuyến nghị bổ sung kiểm thử hành vi ở các bước trung gian bên cạnh đánh giá end-to-end; ví dụ agent có thực sự kiểm tra nguồn, gọi validator hoặc dừng khi thiếu điều kiện hay không. Nguồn: Google Developers Blog.
Triển khai thử theo bốn giai đoạn
1. Baseline: Xác định câu hỏi nghiệp vụ, mẫu tài liệu và bộ nhãn có người kiểm tra. Đo chất lượng, chi phí và độ trễ của cách làm đơn giản trước khi thêm AI.
2. Lọc an toàn: Chuẩn hóa metadata, kiểm tra quyền, loại bản trùng có lưu lineage, phân tuyến PASS / REVIEW / REJECT có mã lý do và cách phục hồi.
3. Thử có đối chứng: Thử từng thay đổi riêng — rule, classifier, chunking, truy xuất lai hoặc rerank. Giữ cùng bộ câu hỏi. Không được chọn một cải tiến nếu nó giảm chi phí nhưng tăng lỗi vượt ngưỡng đã định.
4. Vận hành: Ghi log nguồn và quyết định, lấy mẫu bị loại, thêm ca thất bại vào bộ regression test. Khi thay model, tool hoặc prompt phải chạy lại. n8n mô tả việc phối hợp đánh giá, debug và monitoring trong hướng dẫn vận hành AI.
Chỉ mở rộng nếu có bằng chứng chất lượng đủ ổn định, chi phí/độ trễ chấp nhận được, quy trình REVIEW hoạt động và người phụ trách có thể dừng hoặc sửa hệ thống. Pilot chạy được không đồng nghĩa production đã đáng tin.
Checklist và câu hỏi trước khi mở rộng
- Đã xác định quyết định/đầu ra và ngưỡng lỗi chấp nhận trước khi nói về tiết kiệm?
- Đã tách quyền truy cập bắt buộc khỏi điểm liên quan, và có PASS / REVIEW / REJECT?
- Có nguồn gốc, ngày, phiên bản, lý do loại và khả năng truy hồi?
- Có tập câu hỏi nhiều đáp án đúng lẫn không có đáp án, được người có chuyên môn kiểm tra?
- Có đo bỏ sót cả nhóm REJECT, truy xuất top-k và câu trả lời cuối riêng biệt?
- Claim quan trọng có bằng chứng gốc; số liệu có mẫu số, cấu hình và giới hạn?
- Có test prompt injection, log lỗi, regression, chi phí và độ trễ end-to-end?
- Hành động rủi ro cao có cổng duyệt nằm ngoài AI?
Câu hỏi quan trọng nhất: Nếu một tài liệu thiết yếu bị loại nhầm, hệ thống có tìm lại, giải thích nguyên nhân và kiểm thử để tránh tái diễn được không?
Kết luận: Chưa có một cấu hình lọc tối ưu được chứng minh cho mọi kho dữ liệu. Hệ thống đáng tin biết khi nào cần truy xuất thêm, ngừng kết luận và nhờ xác minh. Tiết kiệm chỉ có ý nghĩa sau khi kiểm soát được chất lượng.
Nguồn và cách diễn giải
Nguồn được phân loại theo mức độ chứng cứ. Tài liệu sản phẩm xác nhận cơ chế; benchmark xác nhận kết quả trong thiết lập thử cụ thể; phản hồi cộng đồng là tín hiệu để kiểm thử chứ không phải kết luận đã kiểm toán:
- Microsoft Learn — Retrieval-augmented generation (RAG) in Azure AI Search: truy xuất lai, xếp hạng, quyền truy cập, ràng buộc token, độ trễ.
- AWS Documentation — Retrieving information from data sources using Amazon Bedrock Knowledge Bases: phân tách Retrieve và RetrieveAndGenerate, reranking, truy xuất nhiều bước.
- Microsoft Foundry — RAG Evaluators: đo riêng retrieval, groundedness, completeness và đối chiếu ground truth.
- Google Developers Blog — The Anatomy of Harness Engineering: kiểm thử hành vi trung gian và hồi quy bên cạnh đánh giá toàn luồng.
- n8n — AI Agent Reliability: hướng dẫn debug, evaluation, metrics và monitoring; không phải phép thử hiệu quả của bài này.
- Anthropic Engineering — Introducing Contextual Retrieval: phép thử do nhà cung cấp công bố, có phương pháp và tỷ lệ thất bại top-20, không suy rộng kết quả sang mọi production.
- Wix Engineering & WixQA — công bố dữ liệu, nghiên cứu: benchmark dựa trên câu hỏi thực và nhãn chuyên gia, không phải thước đo ROI.
- r/Rag — phản hồi thực hành trái chiều: người đăng tự báo cáo số liệu, chưa kiểm chứng độc lập.
- OWASP — LLM01:2025 Prompt Injection: mô hình rủi ro và biện pháp kiểm soát.
- Liu và cộng sự — Lost in the Middle: nghiên cứu công bố về tác động vị trí thông tin trong ngữ cảnh dài; kết quả thử trên mô hình/thời điểm cụ thể, không được suy ra mọi mô hình hiện hành đều có cùng mức suy giảm.
Bối cảnh phát triển khung tư duy: Hệ thống ghi chú cá nhân được dùng để định tuyến từ Raw → Concepts → Outputs và đặt câu hỏi về ranh giới giữa nguồn, nhận định AI và sản phẩm đầu ra. Ghi chú cá nhân không tự động là chứng cứ cho claim kỹ thuật. Bài chỉ trích các số liệu công khai kèm ngữ cảnh và giới hạn nguồn, không sử dụng dữ liệu đo lường nội bộ hay thông tin riêng tư.
Trạng thái kiểm chứng: Đã đối chiếu nguồn kỹ thuật công khai ngày 08/10/2026; chưa thực hiện phép thử độc lập trên hệ thống cá nhân. Do vậy những khuyến nghị về kiến trúc được trình bày là đề xuất cần thử, không gắn nhãn “đã triển khai thành công”.